Il reparto Marketing di Reverse usa l'AI da circa tre anni, da ottobre 2023.
Reverse è una società di Headhunting e il nostro Marketing è B2B. Siamo una realtà di circa 80 persone che lavora in Italia, Francia, Germania e Spagna. Il reparto Marketing è piccolo: in questi tre anni siamo stati tra le due e le quattro persone.
Tutto quello che racconto è successo lì, e in buona parte è verificabile perché è pubblicato: articoli, newsletter, immagini.
Il perimetro di questo report è esclusivamente il Marketing: non sto raccontando come Reverse usa l'AI nei processi di selezione, né il trattamento di CV, dati di candidati o informazioni dei clienti.
3 annidi AI
B2Bmarketing
~80persone
4Paesi
All'inizio usavamo l'AI per fare singole cose. Tre anni dopo, il cambiamento vero è stato smettere di ragionare per task e costruire un sistema: scrittura, immagini, traduzioni e GEO hanno smesso di essere esperimenti separati e sono entrati in un modo di lavorare condiviso. È il punto a cui siamo arrivati nel 2026 e lo racconto nel capitolo 5. Prima, è interessante vedere cosa ci ha portati fin lì.
Questo non è un censimento di tutto quello che l'AI può fare nel Marketing. È il racconto delle aree in cui oggi, nel nostro reparto, ha modificato il modo di lavorare. Mi aspetto che cambierà ancora molto, e molto in fretta.
Questo non è un lavoro finito: l'AI è ovviamente un cantiere aperto. Quello che è qui ora vale per l'agosto 2026 in cui scrivo.
Ottobre 2026Alcune cose raccontate qui sono già cambiate: la prima rilevazione GEO è conclusa e oggi lavoro in parallelo su Claude e ChatGPT. Ne parlo in un secondo articolo, insieme alle decisioni prese nelle settimane successive: Lavorare con l'AI nel Marketing B2B: progetti, deleghe e decisioni
1. Scrivere con l'AI
Tre fasi da ottobre 2023 a oggi: prima le facevamo scrivere tutto, poi le toglievamo i tic, oggi la usiamo per quello che viene prima e dopo la scrittura.
Il nostro rapporto con la scrittura con l'AI ha avuto tre fasi, che messe in fila così sembrano più logiche di quanto mi sembrassero mentre le vivevo.
1.1 Quando sembrava facilissimo
Abbiamo iniziato a usare ChatGPT a ottobre 2023: scrivevamo nel prompt la macro-idea che avevamo in mente, il target, il canale, e chiedevamo il testo intero. Come insegnavano le prime linee guida che giravano all'epoca. Poi lo modificavamo parecchio, ma la base c'era. E sembrava ottima.
La sensazione era di magia. I testi sembravano scritti benissimo. E lo erano, in un certo senso: italiano corretto, periodi ordinati, mai una sbavatura. Solo che è un italiano che non usa nessuno, nemmeno in un documento aziendale formale. Allora non lo vedevo perchè di testi così in giro ce n'erano ancora pochi. Oggi quella scrittura la riconosce chiunque perché la leggiamo dappertutto. Alcuni articoli di quel periodo sono ancora online: i contenuti sono validi, ma la scrittura porta i segni di quella fase, e li stiamo aggiornando.
1.2 Quando toglievamo i trattini
I trattini, le triplette di aggettivi, il pathos forzato, tutti i tic dell'AI. Abbiamo investito diverso tempo a creare skill e istruzioni con divieti, le nostre preferenze, esempi di testi scritti da noi come reference. Un lavoro lungo che sostanzialmente non ha funzionato: il risultato restava scrittura da AI che mi risultava quasi più fastidiosa di prima. In effetti stavamo medicando il sintomo ma la patologia restava.
In quel periodo abbiamo capito che il problema non è tanto la forma quanto il fatto che le idee che ci dà l'AI e che ci sembrano così brillanti in realtà non lo sono.
In particolare sono successe due cose:
ho cominciato a notare che altri contenuti del nostro settore uscivano con i nostri stessi temi. Qualche volta sarà stata una coincidenza. Ma il sospetto è un altro: l'AI stava dando a tutti lo stesso suggerimento.
ho studiato un po' per capire davvero come l'AI produce le idee che ci dà.
Quelle idee più che brillanti erano disponibili.
L'AI sta uniformando le idee che decidiamo di condividere, non solo il nostro stile di scrittura. Oggi per fortuna se ne stanno accorgendo in molti, ma ancora si vedono in giro tanti testi fintamente brillanti. E in effetti è difficile non farsi ammaliare dalle proposte dell'AI, che ci fanno sentire così intelligenti. Ma se in tanti chiediamo all'AI idee sulle tematiche che possono interessare ad un HR Manager per poter rimpinzare i nostri blog, senza metterci niente di nostro, riceveremo tutti gli stessi suggerimenti. E l'uniformità del pensiero è molto più pericolosa di qualche aggettivo ridondante.
Questo non significa che l'AI debba restare fuori dal ragionamento. Oggi la usiamo moltissimo proprio per pensare meglio. Ma c'è una differenza tra usarla per allargare, verificare e mettere in ordine il pensiero, e invece lasciarle decidere quale pensiero è di valore.
E così siamo passati alla fase 3.
1.3 Come lavoriamo oggi: scrivere con l'AI senza far scrivere l'AI
Dal tentativo fallito abbiamo capito che l'AI è utilissima per scrivere ma non va usata per scrivere.
La distinzione è banale ed è questa: produrre contenuti e scrivere non sono la stessa cosa. La scrittura è uno dei pezzi. Prima ci sono il brief, l'obiettivo, il target, la scelta dell'angolo, la ricerca, il confronto tra fonti, la struttura, l'ordine delle idee, i buchi logici da trovare. E dopo ci sono la revisione, le alternative, la correzione. L'AI è preziosa in quasi tutto questo elenco. Il punto in cui la maggior parte delle persone la usa, la scrittura vera e propria del testo che ho intenzione di pubblicare, ad oggi penso sia l'unico punto in cui non conviene.
Approfondimenti
Tre casi concreti dietro la terza fase.
A
Un esempio dal nostro blog
Della normativa sulla trasparenza salariale si è scritto ovunque nel mondo HR, e non volevamo aggiungere l'ennesimo pezzo banale. La sfaccettatura giusta ci è arrivata da una keyword che volevamo coprire da tempo: la valutazione delle performance. Ma la keyword ti dice di cosa parlare, non cosa dire. Unendo i puntini (keyword + tema di attualità) e confrontandoci con i colleghi Head Hunter, siamo arrivati alla riflessione che se devi dichiarare quanto paghi le persone devi poterlo giustificare in modo oggettivo, e quindi serve una valutazione strutturata, anche in un'azienda piccola.
Keywordnata da un lavoro SEO fatto con l'AI
Trendla trasparenza salariale, sotto gli occhi di tutti
Sfaccettaturapensata da noi: chi dichiara le retribuzioni deve poterle giustificare
Scalettapreparata dall'AI
Bozzascritta da noi, con il coinvolgimento dei colleghi Head Hunter
Revisionedi entrambi
Il flusso quindi è stato: la keyword è nata da un lavoro SEO fatto con l'AI, il trend era sotto gli occhi di tutti, la sfaccettatura giusta l'abbiamo pensata noi, l'AI ha preparato la scaletta, noi abbiamo scritto la bozza inserendo la voce autentica nell'articolo, entrambi abbiamo revisionato. Ecco qui.
B
Un'automazione per la ricerca delle tematiche
Fino a poco tempo fa, la consistente parte del lavoro editoriale che sta prima della scrittura la facevamo a mano. Cercavamo le keyword interessanti, controllavamo cosa stava succedendo nel mondo HR, ripercorrevamo quello che avevamo già pubblicato per evitare di ripeterci e provavamo a capire quali temi avessero davvero senso per Reverse.
Oggi gran parte di questa raccolta preliminare è automatizzata. A cadenza regolare, in automatico, Claude ci invia suggerimenti di temi per gli articoli del blog incrociando i criteri che prima verificavamo uno per uno: cosa cercano le persone, attraverso una ricerca keyword sui dati di DataForSEO; cosa si sta muovendo nel settore, attraverso la ricerca dei trend; cosa abbiamo già trattato, grazie al nostro storico; e cosa è particolarmente coerente con Reverse, perché conosce il nostro posizionamento, la nostra identità e il tipo di contenuti che vogliamo produrre.
cosa cercano le persone keywordcosa si muove nel settore trendcosa abbiamo già trattato storicocosa è coerente con Reverse posizionamento
A quel punto potevamo scegliere se usare il tempo risparmiato per produrre più contenuti o per dedicare più effort "umano" ad ognuno di questi. Abbiamo preferito la seconda scelta perché per il momento storico di Reverse l'abbiamo vista più utile. Quindi abbiamo letto molto di più, anche fuori dal perimetro HR, per intercettare idee, fenomeni e collegamenti da aggiungere a quelli segnalati dall'AI; e abbiamo iniziato a chiedere molto più spesso ai nostri Head Hunter il loro punto di vista sui temi di cui vogliamo scrivere: il loro sguardo sul mercato è più aggiornato di qualsiasi ricerca.
In questo modo concretizziamo quello che tutti professano: il tempo che l'AI ti fa risparmiare lo usi per attività in cui l'apporto umano è insostituibile.
C
I "drittoni" e l'AI che ti porta a spasso
L'AI tende a prendere quelli che io chiamo "drittoni": vede un'evidenza nei dati, non l'unica e a volte nemmeno la più interessante, e ti imposta tutta l'analisi su quella. Pensa che una sfaccettatura della tua idea sia vincente, e dimentica tutte le altre. Non è che l'AI sbagli: sceglie, ma non ti dice di aver scelto. Poi rileggi i dati grezzi della tua indagine e trovi cose ottime che l'AI ha semplicemente ignorato. Spesso è il prompt iniziale il problema: "analizza le risposte e scrivi un report" è un invito al drittone. Secondo me è meglio non usare l'AI se lo fai così. Perché dia valore aggiunto abbiamo risolto dedicando parecchio tempo a definire cosa conta per noi, prima che scelga l'AI: quante risposte servono perché un'evidenza sia un'evidenza, quali aspetti consideriamo scontati e non vogliamo in analisi, eccetera. È un lavoro lungo che ha senso fare per i lavori che ci capitano spesso, non per quelli una tantum o occasionali.
Il drittone è un caso particolare di una tendenza generale. L'AI è costruita per non mollarti: ogni risposta arriva piena di suggerimenti, idee, complimenti, strade nuove, come i social sono costruiti per farti restare. Se le segui tutte, dopo qualche scambio ti ritrovi lontano dalla domanda iniziale. Stiamo trovando utile tenerla "al guinzaglio" e ogni tot fare un punto della situazione del progetto, soprattutto verificando cosa l'AI ha lasciato fuori.
Questo report ne è un esempio: l'ho scritto chiedendo a Claude di farmi domande, una alla volta, per mettere in ordine tre anni di ricordi di team e documenti vari, e dandogli l'indicazione precisa di non produrre nessun output, neanche una bozza del testo, ma tenere un log di tutto quanto emergeva sia dall'intervista sia da mie considerazioni sparse che aggiungevo al progetto quando mi venivano in mente.
Il problema era creare decine di immagini con diversi soggetti ma mantenendo lo stile di brand. Dopo tre tentativi, a marzo 2025 abbiamo comprato da un’agenzia non un pacchetto di visual ma il codice per generarli.
Il nostro problema con le immagini è quello che hanno in molti: ne servono tante, a noi una decina al mese tra blog e social, e devono essere tutte allineate alla brand identity. Se non hai qualcuno che disegna per te non è semplicissimo.
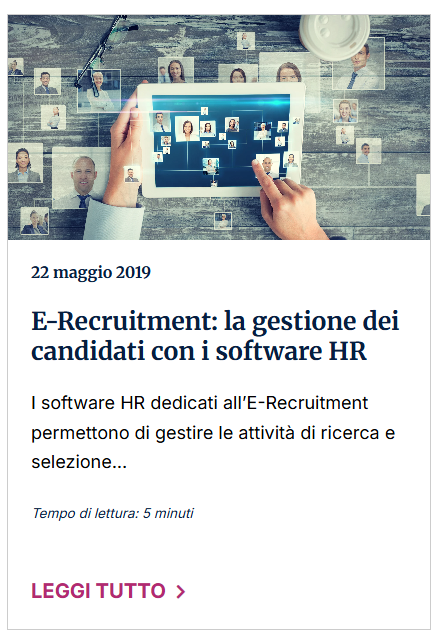
Per anni l'abbiamo risolta come la risolvevano tutti: immagini di repertorio, Unsplash e simili. Costano poco e più o meno vanno sempre bene. Ovviamente però le stesse foto che usavamo noi erano ovunque e soprattutto erano sui siti dei competitor. Riconoscibili come "immagini comprate", cioè il contrario di uno stile di brand.
22 maggio 2019: il primo articolo del blog di Reverse, con un'immagine di repertorio.
Abbiamo quindi provato a costruire qualcosa di nostro.
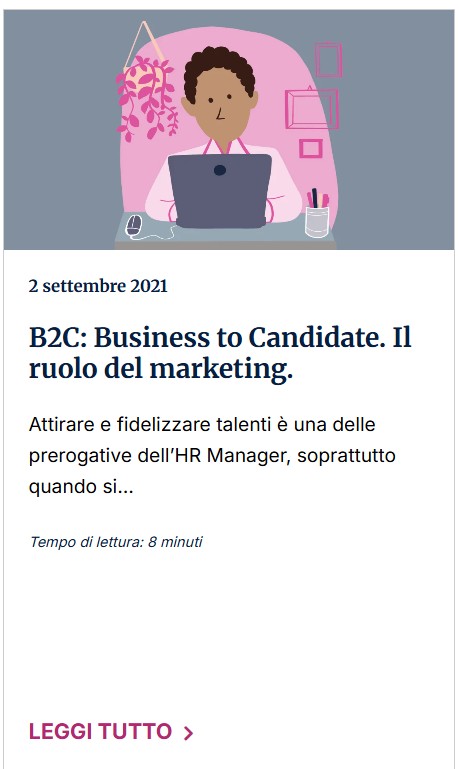
Il primo tentativo per ritrovare sempre le nostre linee guida di brand è stato commissionare una ventina di immagini a un grafico professionista. Coerenti e riconoscibili, ma finite in due mesi. Continuare a produrle in quel modo avrebbe richiesto un investimento costante, di budget affidandosi all'esterno o di tempo portando il lavoro dentro.
2 settembre 2021: un articolo del blog con un'immagine commissionata al grafico.
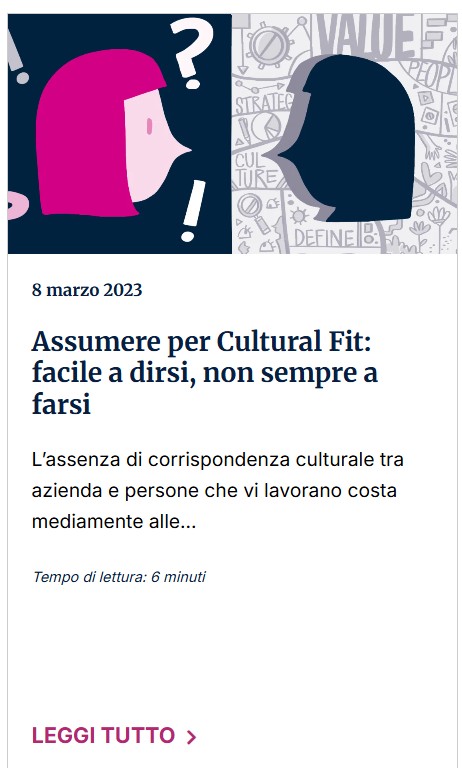
Il secondo tentativo cercava di risolvere proprio la scalabilità e ci era sembrato molto più furbo: invece di immagini finite, ci siamo fatti preparare gli elementi separati - sfondi, figure, oggetti - da combinare noi ogni volta in modo diverso. In teoria, combinazioni infinite. In pratica, dopo un po' le immagini sembravano tutte uguali e il montaggio ci richiedeva parecchio tempo.
8 marzo 2023: un articolo del blog con un'immagine montata da elementi separati.
A quel punto, agli albori di ChatGPT, la generazione con l'AI sembrava la soluzione più ovvia. Nei primi tentativi, però, riuscivamo magari a ottenere una bella immagine, ma il problema era ottenere oggi un'immagine e dopo due giorni generarne un'altra, su un soggetto completamente diverso, che appartenesse esattamente allo stesso mondo visivo.
È una difficoltà che sento ancora oggi: generare un'immagine corretta per un brand è relativamente facile ma costruire uno stile riconoscibile e riuscire a ripeterlo decine di volte richiede una competenza che non tutti hanno in casa.
La soluzione per noi è arrivata a marzo 2025, grazie a un light rebranding. Abbiamo coinvolto un'agenzia specializzata nell'uso dell'AI per la creatività e le abbiamo dato un brief che potevano trovare sfidante o esasperante (è andata bene): volevamo eliminare i volti umani dalle nostre immagini, sia quelli di repertorio sia quelli dei colleghi che in passato si erano gentilmente prestati, continuando però a comunicare umanità insieme a tecnologia e trasparenza.
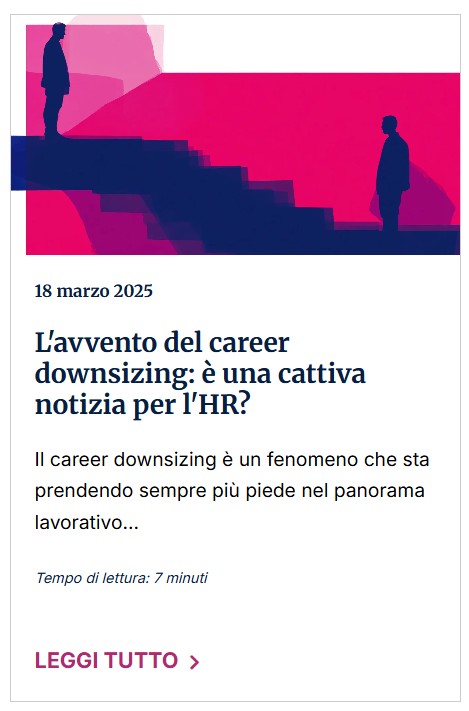
L'agenzia ha costruito il nostro nuovo linguaggio visivo, e fin qui abbastanza normale. Ma la cosa importante è che quello che ci hanno consegnato non è stato un pacchetto di immagini ma un prompt. Una stringa per Midjourney. E questo è il cuore: nel prompt è codificato lo stile che l'agenzia ha progettato per noi. Per generare un nuovo visual dobbiamo indicare essenzialmente il soggetto. Il resto - tipo di immagine, atmosfera, composizione, materiali, resa - viene ricostruito ogni volta a partire da quelle istruzioni.
18 marzo 2025: un articolo del blog con un'immagine generata con Midjourney dal prompt dell'agenzia.
È passato più di un anno e nel frattempo sono cambiate anche diverse versioni di Midjourney. Quel prompt continua a funzionare e oggi praticamente tutte le immagini che produciamo nascono da lì e richiedono pochi minuti. Investimento super ok.
Per la prima volta abbiamo comprato le istruzioni per generare l'output invece dell'output.
Quello che mi sembra interessante è che per noi è stata la prima volta in cui per ottenere l'output abbiamo comprato qualcosa di diverso: le istruzioni per generarlo, un prompt, invece del prodotto finito.
Da traduzioni manuali dei madrelingua a istruzioni date all’AI per tradurre mantenendo il nostro tone of voice, più un controllo a valle dei madrelingua, soprattutto in tedesco.
Il blog di Reverse esce anche in francese, tedesco e spagnolo. Fino alla fine del 2024 compravamo le traduzioni all'esterno, spendendo qualche centinaio di euro al mese. Con quel modello, sui blog esteri riuscivamo a pubblicare circa un articolo ogni due mesi.
Allora, dato che stavamo già usando parecchio l'AI, abbiamo iniziato a valutarla anche per migliorare il flusso delle traduzioni. Per un lungo periodo abbiamo sottoposto ogni testo tradotto dall'AI a un madrelingua prima della pubblicazione. Per capire quanto potevamo fidarci dell'AI abbiamo analizzato le revisioni dei madrelingua. Su 10 traduzioni controllate, solo una ha richiesto una modifica di struttura - in tedesco, che è sempre la lingua più delicata (e questi trattini non li ha messi l'AI) - e in quattro casi sono state riviste singole scelte linguistiche. Negli altri casi il testo è stato validato senza interventi sostanziali.
È stato questo periodo di verifica a farci cambiare processo: a giugno 2026 abbiamo raddoppiato la frequenza e siamo passati da un articolo ogni due mesi a uno al mese per lingua. La rilettura dei madrelingua è stata spostata a valle della pubblicazione. La scelta è arrivata per gradi, osservando per mesi cosa succedeva sui nostri testi. Quando il controllo ha continuato a confermare la qualità dell'output, abbiamo smesso di considerarlo un passaggio bloccante.
Nel frattempo abbiamo lavorato parecchio sulle istruzioni da dare all'AI. Per le traduzioni abbiamo costruito una skill in Claude e ci abbiamo messo dentro tutto quello che avevamo: cosa vogliamo e cosa non vogliamo nella resa, il lessico Reverse nelle tre lingue, le vecchie traduzioni fatte dai professionisti come riferimento e, soprattutto, quello che non aveva funzionato nelle prime prove con l'AI. Abbiamo incorporato progressivamente le correzioni dei madrelingua nelle istruzioni e negli esempi della skill. L'obiettivo è conservare il più possibile lo stile Reverse, evitando traduzioni piatte o troppo neutre.
Poi c'è una cosa che a una traduzione non avevamo mai chiesto. Prima di tradurre, l'AI ci aiuta a valutare se l'articolo funziona anche fuori dall'Italia: se esempi e fonti citate hanno senso per un lettore tedesco, francese o spagnolo e, se no, con cosa potremmo sostituirli; se parliamo di normative, come cambiano in Germania, Francia e Spagna e come andrebbe adattato il passaggio. Anche qui niente output subito: prima l'AI ci dice cosa farebbe, noi leggiamo, scegliamo cosa validare e cosa no, e solo dopo le diamo l'ok a procedere.
Per noi era anche una necessaria ottimizzazione dei costi. Mantenere il vecchio processo avrebbe significato aumentare la spesa oppure continuare a pubblicare molto poco sui mercati esteri. Oggi possiamo dare più valore pubblicando il doppio dei contenuti.
Il controllo umano è rimasto e oggi ha una funzione diversa: verifica che il risultato continui a essere corretto, naturale e coerente con Reverse.
Non ne ricavo una regola generale sulla traduzione. Per noi, al momento, questa è la situazione ottimale.
Risultati positivi già con i primi interventi sul sito; ora sta partendo un progetto dedicato, prima manuale e poi automatizzato.
4.1 I primi segnali dai prospect
Con la SEO per ora l'AI ci ha aiutati senza cambiarci particolarmente la vita. La usiamo per rendere più veloci e completi alcuni lavori di keyword research e per incrociare intenzioni di ricerca e storico dei nostri contenuti. Funziona, ci fa risparmiare tempo, ma non è una delle aree in cui direi che abbiamo fatto qualcosa di particolarmente avanzato.
Sulla GEO invece il percorso è iniziato quasi al contrario: prima abbiamo visto dei movimenti positivi, poi abbiamo iniziato a capire da cosa potesse dipendere, e infine ci stiamo strutturando perché accada sempre di più.
È andata così. Alcuni prospect hanno iniziato a dirci di aver trovato Reverse chiedendo a ChatGPT, Claude, Gemini e perfino Grok. Non avevamo fatto nulla di specifico per ottenere quel risultato, quindi la prima reazione è stata semplicemente capire come mai stesse succedendo (qualche bella sorpresa ogni tanto).
Abbiamo iniziato a studiare come gli LLM recuperano le informazioni, quali fonti usano e cosa rende un contenuto più facile da interpretare e citare. Da lì abbiamo fatto i primi interventi mirati, soprattutto sul sito: rendere più esplicite alcune informazioni, strutturare diversamente certe pagine, lavorare sulla leggibilità dei contenuti anche dal punto di vista dei modelli.
A quel punto abbiamo iniziato a misurare cosa succedeva dopo le modifiche. Il monitoraggio era ancora molto artigianale e non avevamo una vera baseline, quindi non posso dire quanto di quello che vedevamo dipendesse direttamente dai nostri interventi. Però i segnali continuavano ad arrivare e ci sembravano abbastanza interessanti da giustificare un lavoro più serio.
È da lì che nasce il progetto che stiamo costruendo adesso: smettere di guardare casi singoli e provare ad agire e a misurare in modo strutturato quanto, dove e perché Reverse compare nelle risposte degli LLM.
Ma c'è una notizia: sugli LLM non sappiamo cosa le persone cerchino.
Con la SEO siamo abituati a vedere le query che hanno generato impression e clic.
Con gli LLM questa informazione non ce l'abbiamo. Se un HR Manager chiede a Claude quali società di Head Hunting potrebbe valutare per una certa ricerca e tra le risposte compare Reverse, noi non vediamo quel prompt da nessuna parte.
Quindi per misurare il nostro posizionamento abbiamo cominciato, come tutti, da una cosa abbastanza strana: ipotizzare le domande che potrebbero fare i nostri prospect.
La keyword research della SEO è stata una delle basi, ma abbiamo capito presto che non potevamo limitarci a trasformare una keyword in una domanda.
Su Google posso scrivere:
Su Googlesocietà head hunting automotive
A un LLM"Devo assumere un responsabile commerciale nel settore automotive. Faccio fatica a trovare persone con una certa esperienza e cerco una società specializzata: quali player del nord Italia dovrei valutare?"
A un LLM posso raccontare la mia situazione e lui ha già in memoria molte informazioni su di me che influenzeranno la risposta.
4.2 Ipotizzare i prompt degli utenti
Abbiamo quindi usato Claude per costruire un panel di possibili prompt.
Abbiamo provato a renderlo abbastanza ampio e strutturato: diversi tipi di bisogno, momenti del processo di acquisto, formulazioni più generiche o più specifiche, richieste di confronto tra fornitori, problemi per cui un prospect potrebbe non sapere ancora di aver bisogno di un Head Hunter. Poi li abbiamo raggruppati in cluster.
È stato un lavoro piuttosto lungo, ma mi è sembrato sensato farlo bene, perché tutto quello che misureremo dopo dipenderà da questa base.
Il risultato quindi non è "la lista delle cose che i nostri prospect chiedono agli LLM" ma è la nostra migliore ipotesi. Quindi questo è il primo grosso limite del progetto: se sbagliamo il panel, possiamo misurarlo benissimo e continuare a non sapere cosa succede davvero.
Per ora non vedo una soluzione migliore.
4.3 Una prima baseline manuale
A quel punto abbiamo iniziato a far girare i prompt.
La prima rilevazione la stiamo facendo manualmente, su sei piattaforme AI (ChatGPT, Claude, Gemini, Perplexity, Copilot e le AI Overview di Google, che contiamo separatamente da Gemini), quando possibile in incognito quindi senza contesto Reverse. È lenta, ma prima di automatizzare qualcosa di così nuovo mi sembra meglio interiorizzarlo bene.
6piattaforme AI
2volte per prompt
2condizioni, con e senza ricerca web
La prima rilevazione, manuale e in incognito
Ogni prompt lo facciamo girare due volte e in due condizioni: con la ricerca web attiva e senza, dove la piattaforma lo permette. La stessa domanda può infatti produrre risposte diverse a seconda del modello, del momento e del contesto della conversazione.
Per questo sto cercando di evitare l'idea di una "classifica" tipo SEO: dire "siamo primi su ChatGPT" penso che avrebbe poco senso. Quello che possiamo osservare è piuttosto quanto spesso compariamo, in quali contesti, accanto a chi e attraverso quali fonti.
Quindi annotiamo:
se Reverse compare oppure no;
se la descrizione di Reverse è corretta;
con quale pagina o fonte;
quali competitor vengono suggeriti;
soprattutto, quali tipi di fonti vengono citati.
Su quest'ultimo punto mi sto soffermando molto: mi interessa capire se, quando un LLM cita una società di Head Hunting, si sta appoggiando soprattutto al sito corporate, al blog aziendale, ad articoli della stampa, a portali verticali, a Reddit, a LinkedIn o ad altre fonti.
Perché questa informazione potrebbe diventare utile anche fuori dalla GEO: se in un certo cluster vediamo emergere soprattutto fonti giornalistiche, potrebbe voler dire che lì le PR hanno un peso maggiore. Se compaiono soprattutto contenuti approfonditi pubblicati dalle aziende, potrebbe essere un segnale per lavorare di più sul content. Se ricorrono alcune pagine dei competitor e le nostre no, possiamo andare a vedere cosa contengono.
4.4 Il ciclo automatizzato
In questo momento siamo esattamente qui. Stiamo raccogliendo la prima baseline, ed è un lavoro abbastanza lungo.
Il passaggio successivo sarà automatizzarlo. La strada che stiamo studiando è n8n: far girare periodicamente lo stesso panel di prompt, raccogliere le risposte e restituirci dati confrontabili nel tempo.
L'ipotesi, oggi, è una rilevazione mensile.
A quel punto il ciclo dovrebbe diventare:
Rilevazione
Lettura dei risultati
Azioni SEO, content, PR o altro
Nuova rilevazione
Confronto con la precedentee si ricomincia
Restano parecchi punti di domanda. Il panel rappresenta abbastanza bene le domande reali dei prospect? Quante ripetizioni servono prima che una variazione smetta di sembrare rumore? Quanto potremo modificare i prompt nel tempo senza perdere la confrontabilità con la baseline? E quanto sarà davvero possibile collegare una nostra azione a un cambiamento nelle risposte? E quando il panel girerà via API, le risposte arriveranno spesso da modelli o configurazioni diverse da quelle che un utente trova nell'interfaccia: non è detto che misurino la stessa cosa.
5. Avere un sistema e non delegare all'AI singole task
Due anni di abitudini individuali sono diventati un sistema condiviso e misurabile. È il punto di arrivo del report.
Per i primi due anni e mezzo l'AI nel nostro reparto è stata soprattutto una somma di abitudini individuali. Ognuno aveva i suoi prompt, i suoi trucchi, gli strumenti che preferiva. Quando qualcuno scopriva qualcosa di utile lo raccontava agli altri e, poco alla volta, il modo di lavorare migliorava.
Nella prima metà del 2026 abbiamo provato a mettere ordine in quello che avevamo imparato e trasformarlo in un sistema condiviso.
La costruzione vera e propria ha richiesto poche settimane. Il lavoro che ci stava dietro, in realtà, durava da molto di più: due anni di tentativi, errori, istruzioni accumulate e piccoli processi che a un certo punto aveva senso collegare tra loro.
Un ecosistema deve per forza vivere su un solo LLM, senza escludere del tutto gli altri.
Per costruire il sistema abbiamo dovuto fare una scelta che fino a quel momento avevamo evitato: decidere dove farlo vivere.
Abbiamo scelto Claude. Oggi circa l'80% del nostro lavoro con l'AI passa da lì.
80%circa, del lavoro con l'AI passa da un solo strumento
Senza abbandonare ChatGPT e altri modelli per lavori specifici, oltre ad ambienti "vuoti" di controllo
La ragione principale è la continuità. Se progetti, istruzioni, file e conoscenza sono sparsi tra strumenti diversi, ogni conversazione riparte con una parte di contesto in meno. Per far funzionare davvero questo tipo di sistema serve rimanere abbastanza a lungo nello stesso ambiente perché il contesto si accumuli e possa essere riutilizzato.
ChatGPT continua a far parte degli strumenti che usiamo, così come proviamo altri modelli quando hanno caratteristiche particolarmente adatte a un singolo lavoro. Li tengo anche d'occhio perché il mercato si muove troppo velocemente per dare per definitiva una scelta fatta oggi. Un nuovo modello può cambiare gli equilibri nel giro di poche settimane.
Cambiare strumento di riferimento ogni mese, però, renderebbe impossibile accumulare davvero il vantaggio del sistema. Quindi per ora la scelta è Claude. Se un giorno avrà senso spostare tutto altrove, valuteremo come farlo.
Ottobre 2026Poche settimane dopo la pubblicazione mi sono trovata a rimettere in discussione questa scelta. Lo racconto qui: Lavorare con due LLM
Quando troppo contesto peggiora il risultato
C'è anche un rovescio che ho imparato usando sempre lo stesso ambiente: più contesto a volte può non portare a risposte migliori. A volte orienta troppo il modello e il risultato peggiora.
Quando ho questo dubbio faccio una prova molto semplice: ripeto la stessa domanda in una chat in incognito, senza tutto il contesto Reverse intorno, o in un altro tool. Se le due risposte divergono molto, ho almeno un'indicazione di quanto quello che Claude sa di noi stesse condizionando il risultato.
5.2 Permessi e confini dell'AI
Linee guida fissate a monte: cosa possiamo condividere e cosa no con l'AI.
Prima di costruire il resto servivano alcune regole.
In Reverse si è deciso che è possibile condividere con l'AI le strategie e i materiali di Marketing entro i limiti previsti dall'azienda e dagli accordi di riservatezza. Per il resto esercitiamo un giudizio su quello che entra nel sistema, e alcune cose abbiamo deciso di tenerle fuori.
L'AI conosce ruoli e responsabilità delle persone, perché questo contesto serve continuamente nel lavoro. Sa, per esempio, che preparare qualcosa per il CEO richiede un output diverso da quello destinato a una collega.
Le opinioni personali su colleghi e fornitori restano fuori. Lo stesso vale per informazioni e piani che devono ancora essere comunicati ufficialmente. Qualsiasi informazione inserita nel sistema può infatti riaffiorare più avanti dentro un output diverso da quello per cui era stata fornita.
Sono regole abbastanza semplici, però diventano importanti quando l'AI smette di essere una chat usata ogni tanto e comincia a conoscere davvero l'azienda.
Dentro
strategie e materiali Marketing
ruoli e responsabilità
Fuori
quanto coperto da accordi di riservatezza
opinioni personali
piani ancora da comunicare
5.3 I mattoni
Nel nostro caso, attualmente una quindicina di progetti, una decina di skill e alcune istruzioni permanenti.
Oggi il sistema Marketing è composto da un set di istruzioni permanenti, una quindicina di progetti e una decina di skill.
Istruzioni permanentiregole trasversali
Progetticontesto stabile
Skillprocedure ricorrenti
All'inizio ho sperimentato parecchio su come organizzarli. Alla fine mi sono trovata bene usando queste funzioni così come Claude stesso suggerisce di usarle: i progetti raccolgono lavori che hanno bisogno di un contesto stabile, le skill codificano procedure che tornano spesso, le istruzioni permanenti tengono ferme alcune regole trasversali.
Per me era importante provarlo prima di adottarlo. Con strumenti così nuovi le convenzioni stanno ancora nascendo e il fatto che una piattaforma suggerisca un certo uso non significa che debba funzionare per forza nel nostro modo di lavorare.
Ci siamo dovuti dare anche un minimo di burocrazia: definire per ogni progetto a cosa serve, quali file deve usare, dove si trova la fonte di verità, quali regole seguire, in che lingua e con quale tono lavorare.
Sono piccole regole condivise che evitano di costruire mille modi personali diversi di usare la stessa cosa. Oggi una persona del team può entrare in un progetto creato da un'altra e trovare già l'ambiente di lavoro impostato.
Abbiamo portato questa logica anche sulla memoria dei singoli lavori.Quando parte un progetto abbastanza strutturato apriamo un progetto dedicato in Claude e gli associamo un file di log in Notion. Alla fine di ogni sessione Claude sa che deve aggiornare quel file con quello che è successo: decisioni prese, ipotesi scartate, cose ancora da verificare, prossimi passi e chi deve fare cosa.
Il file di log è scritto più per Claude che per noi e proprio per questo può permettersi di essere poco user friendly. Quando riprendiamo un lavoro dopo qualche giorno o qualche settimana chiediamo direttamente: "Dove eravamo rimasti?", "Cosa dovevo fare io?", "Quale ipotesi avevamo escluso?". Claude recupera il log e ci rimette nel progetto.
In più questi log alimentano in automatico la knowledge base di cui parlo qui sotto. Quindi le decisioni prese nei singoli progetti non rimangono chiuse lì dentro: diventano progressivamente parte del contesto con cui Claude affronta i lavori successivi.
1 progetto di lavoro→1 progetto Claude→1 log Notion, aggiornato a ogni sessione→knowledge base
5.4 La knowledge base del Marketing
La nostra bibbia in costante aggiornamento.
A un certo punto ho iniziato a notare che Claude recuperava pezzi di lavori precedenti mentre stavamo facendo altro: una campagna vecchia, una decisione presa mesi prima, un ragionamento sviluppato dentro un altro progetto.
Ho iniziato quindi a costruire volontariamente quel contesto.
Abbiamo raccolto in un unico documento la storia del Marketing di Reverse: attività fatte, campagne, decisioni, posizionamento, progetti, risultati, scelte abbandonate. Ho dedicato anche del tempo a ricostruire cose del passato che il modello non poteva conoscere, proprio perché mi interessa che le proposte future partano anche da quello che abbiamo già provato.
Quel documento è diventato la nostra knowledge base e continua a crescere mentre lavoriamo.
Serve soprattutto nei progetti in cui una risposta corretta richiede una visione più ampia del singolo task.
Un esempio: l'analisi dei dati
L'analisi dei dati è uno degli esempi in cui ce ne siamo accorti meglio. Dare all'AI una tabella e chiederle di leggerla è semplice. Ma le analisi in questo modo dicono solo cose ovvie. Diventano tutta un'altra cosa quando l'AI conosce anche le campagne che erano attive in quel periodo, i cambiamenti fatti nel frattempo, i valori che per Reverse sono normali e le decisioni che possono avere influenzato quel dato.
È anche da questa esigenza che è nato il tentativo, ancora aperto, di costruire una dashboard Marketing interrogabile e aggiornata automaticamente. Per ora non abbiamo trovato con l'AI la strada più semplice e stabile per farlo, quindi resta uno degli esperimenti in corso.
La knowledge base ha anche un'utilità più ordinaria: sarà una base eccellente per l'onboarding di chi entrerà nel team, se avrà già familiarità con questo modo di lavorare.
Collaborazione tra team
La stessa logica sta iniziando a uscire dal Marketing. Con i reparti Design, HR e IT abbiamo cominciato a condividere alcune parti operative delle knowledge base: processi, linee guida, formazione e scoperte utili tra team. Alcune informazioni restano specifiche dei singoli team, altre diventano patrimonio comune: così un esperimento utile fatto da uno può entrare rapidamente anche nel modo di lavorare degli altri.
Marketingknowledge formazione scoperteDesignHRIT
5.5 Strumenti collegati
Dal mio poco amore per Notion, un nuovo modo di interagire con i tool.
La knowledge base e una parte del sistema oggi vivono in Notion. È uno strumento che trovo utile anche se l'interfaccia non mi risulta particolarmente intuitiva. L'abbiamo introdotto soprattutto perché Claude può modificare i documenti che sono in Notion, mentre con i file su Google Drive ci ritrovavamo con una nuova versione del documento invece di quella originale aggiornata.
Quindi, data la mia leggera antipatia per Notion, ho iniziato a chiedere a Claude di fare cose lì dentro al posto mio.
Se devo aggiungere alla knowledge base una campagna appena conclusa, gli dico quale pagina aggiornare e cosa inserire (anzi, in linea di massima quale pagina aggiornare lo sa da solo). Se devo modificare una tabella e non ricordo dove si trovi un'impostazione, chiedo a Claude di farlo. Se durante una call emerge una decisione che voglio conservare, gli dico di aggiornare il documento giusto senza aprire Notion e cercare dove andare.
La struttura resta una cosa che ognuno di noi deve conoscere: devo sapere quale pagina è la fonte corretta, cosa voglio venga modificato e poi controllare che sia successo nel posto giusto. Però ho smesso di dover conoscere tutti i passaggi dell'interfaccia per fare un'operazione. È un cambiamento nell'utilizzo dei tool che secondo me è sostanziale, e nel nostro ambito lo sarà soprattutto per i CRM.
Prima
apro Notion → cerco la pagina → trovo dove intervenire → modifico
Oggi
"aggiungi alla knowledge base la campagna appena conclusa e questi risultati"
Una parte del rapporto complicato che Marketing e Sales hanno con questi strumenti nasce anche dalla quantità di operazioni richieste: trovare il deal, aprire la scheda giusta, aggiornare un campo, scrivere una nota, cambiare uno stato, ricordarsi dove va inserita un'informazione.
Mi aspetto che rendere i CRM conversazionali possa cambiare parecchio questa dinamica. Dire, magari con un vocale: "Aggiorna la trattativa: meeting fatto, prossimo contatto a dicembre" è molto più vicino al modo in cui una persona pensa rispetto a compilare manualmente cinque campi diversi.
Un vocale al CRM"Aggiorna la trattativa: meeting fatto, prossimo contatto a dicembre"
È una mia previsione su come cambieranno i CRM, non una descrizione di quello che facciamo oggi con i dati dei clienti: quelli, come detto in apertura, restano fuori dal perimetro di questo report.
Per il Marketing sarebbe particolarmente utile. Più il CRM viene aggiornato bene dai Sales, più possiamo capire cosa succede ai lead dopo che glieli passiamo, quali campagne generano opportunità vere, perché alcune trattative si fermano e dove conviene intervenire. Se aggiornare il CRM diventasse più semplice, potrebbe migliorare anche la qualità dei dati su cui Marketing e Sales discutono insieme.
5.6 Il salto di giugno 2026
Come abbiamo vissuto la nuova generazione dei modelli.
La coincidenza interessante è che abbiamo finito di mettere in piedi buona parte di questo sistema proprio mentre arrivava una nuova generazione di modelli.
Da giugno 2026, per la mia esperienza, il salto è stato molto evidente. Fino a poco prima avevo la sensazione di lavorare con uno stagista eccezionale: velocissimo, disponibile, capace di imparare molto, però da seguire continuamente. Con i modelli più recenti la sensazione si è avvicinata molto di più a quella di lavorare con un collega.
La differenza maggiore che vedo nei modelli recenti sia di ChatGPT che di Claude è nella capacità di unire i puntini: recuperare una decisione presa altrove, collegare un lavoro attuale a qualcosa fatto mesi prima, usare informazioni che non ricordavo di avergli dato.
Quindi per noi sistema strutturato per usare l'AI e qualità del modello si sono incontrati. Nel nostro caso, avere già progetti, istruzioni, storico e knowledge base ci ha permesso di sfruttare molto meglio quel salto tecnologico. Il salto di qualità lo fa certamente il modello, ma ne benefici solo se hai preparato il terreno, ovvero se stai lavorando con l'AI in modo costruito.
Ci sono poi alcune aree importanti del Marketing in cui l'AI per noi è entrata poco, oppure in cui il lavoro è ancora troppo acerbo per avere qualcosa di utile da raccontare.
Paid
L'abbiamo usata sia a monte, per ragionare sui brief e sulle strategie delle campagne, sia durante la gestione, per leggere i risultati, cercare anomalie e individuare possibili ottimizzazioni.
Ci è stata utile soprattutto come interlocutore: per mettere in discussione un'impostazione, proporre ipotesi da verificare o farci notare qualcosa che stavamo trascurando.
Qui però il livello di sofisticazione è limitato anche da una ragione molto semplice: in questo momento non gestiamo budget pubblicitari tali da richiedere ottimizzazioni particolarmente avanzate, né volumi di dati che giustifichino sistemi complessi. L'AI ci aiuta, ma finora non ha cambiato in modo sostanziale il nostro modo di fare advertising.
Sul CRM abbiamo già alcune ipotesi interessanti, soprattutto rispetto a quanto potrebbe cambiare quando diventerà più conversazionale, ma il lavoro vero è ancora in corso. C'è un progetto dedicato, che sta facendo i primi passi. Per ora quindi non abbiamo ancora un caso Marketing abbastanza maturo da documentare.
Email Marketing
Qui l'uso è rimasto quasi interamente sul contenuto: testi, oggetti, formulazioni e revisioni della newsletter. Non abbiamo ancora usato l'AI per ripensare segmentazione, automazioni, struttura del canale o customer journey.
Sviluppo web
Di solito collaboriamo con sviluppatori esterni o con il team IT di Reverse. Questa pagina è il primo esperimento fatto in autonomia: l'ho costruita e messa online con Claude Code, senza competenze di programmazione, in poche ore di lavoro. Per le cose complesse continuerà a servire uno sviluppatore, ma essere autonomi sulle piccole è un valore aggiunto notevole per un reparto Marketing. È però un solo esperimento, e finché non se ne aggiungono altri lo lascio qui, tra le aree toccate meno.
Chiusura
Quando ChatGPT è diventato di massa, all'inizio del 2023, ho iniziato a usarlo seriamente a ottobre. Quando Claude è arrivato in Italia, nel 2024, ci ho messo circa cinque mesi. La generazione uscita a giugno 2026 la stavo già provando il giorno dopo.
Ogni volta il tempo si è accorciato.
Più lavoro reale avevamo alle spalle, più diventava facile capire in fretta se un nuovo strumento poteva servirci davvero.
Il progresso va sempre più veloce e non si ferma di fronte a niente: preferisco salire sul carro e provare a governarlo piuttosto che farmi travolgere.
Questo sito utilizza cookie di statistica, per analizzare la lettura dei contenuti, e cookie di marketing, per misurare le campagne pubblicitarie. L'installazione avviene solo previo consenso. Dettagli